
Dans cet article
- Hallucinations IA dans le service client e-commerce : pourquoi l'architecture de contrôle qualité est déterminante
- Ce que les hallucinations IA coûtent aux marques e-commerce
- Pourquoi la plupart des outils de service client automatisé se trompent
- Architecture de contrôle qualité
- Les 14 couches de contrôle qualité de Yuma pour prévenir les hallucinations IA
- Comment évaluer l'approche de votre fournisseur IA e-commerce en matière de précision
- Conclusion
- Questions fréquentes sur les hallucinations, la qualité et la précision dans le service client IA
Hallucinations IA dans le service client e-commerce : pourquoi l'architecture de contrôle qualité est déterminante
Un client expédie trois appareils vers un relais routier. Pas parce qu'il le voulait, mais parce que l'agent IA de service client de sa marque a halluciné une adresse de livraison et lui a demandé de le faire.
Chez une autre entreprise e-commerce, l'IA a affirmé à un client qu'elle avait déjà envoyé un produit de remplacement. C'était faux. Le client a attendu, a relancé, puis s'est mis en colère. L'équipe de service client n'a découvert la réponse inventée que lorsque la plainte a été escaladée.
« Je n'ai absolument plus confiance pour aller de l'avant », a déclaré une directrice du service client après une série d'erreurs IA dans son entreprise. « Je le désactive aujourd'hui. »
Ce ne sont pas des scénarios hypothétiques. Ces situations sont arrivées à de vraies marques e-commerce avec lesquelles nous avons échangé, et à de vrais clients, en 2025 et 2026. Elles ont toutes la même cause profonde : un service client IA automatisé déployé sans l'architecture nécessaire pour garantir sa précision.
Ce que les hallucinations IA coûtent aux marques e-commerce
Le préjudice financier d'une seule hallucination est facile à sous-estimer. Un remboursement erroné ici, un remplacement fictif là. Mais le vrai coût n'est pas l'erreur individuelle, c'est ce qui arrive à la confiance ensuite.
« Ce n'est pas leur réputation, c'est notre réputation », a déclaré une responsable du service client e-commerce après avoir découvert que l'IA de son entreprise inventait des instructions d'expédition. Chez une autre marque, l'IA promettait systématiquement aux clients l'envoi de produits de remplacement pour des commandes endommagées, puis fermait les tickets sans déclencher aucune expédition. L'équipe de service client ne l'a découvert que lorsque des clients frustrés sont revenus plusieurs jours après, générant le double de travail, des temps de résolution allongés et zéro capital de confiance.
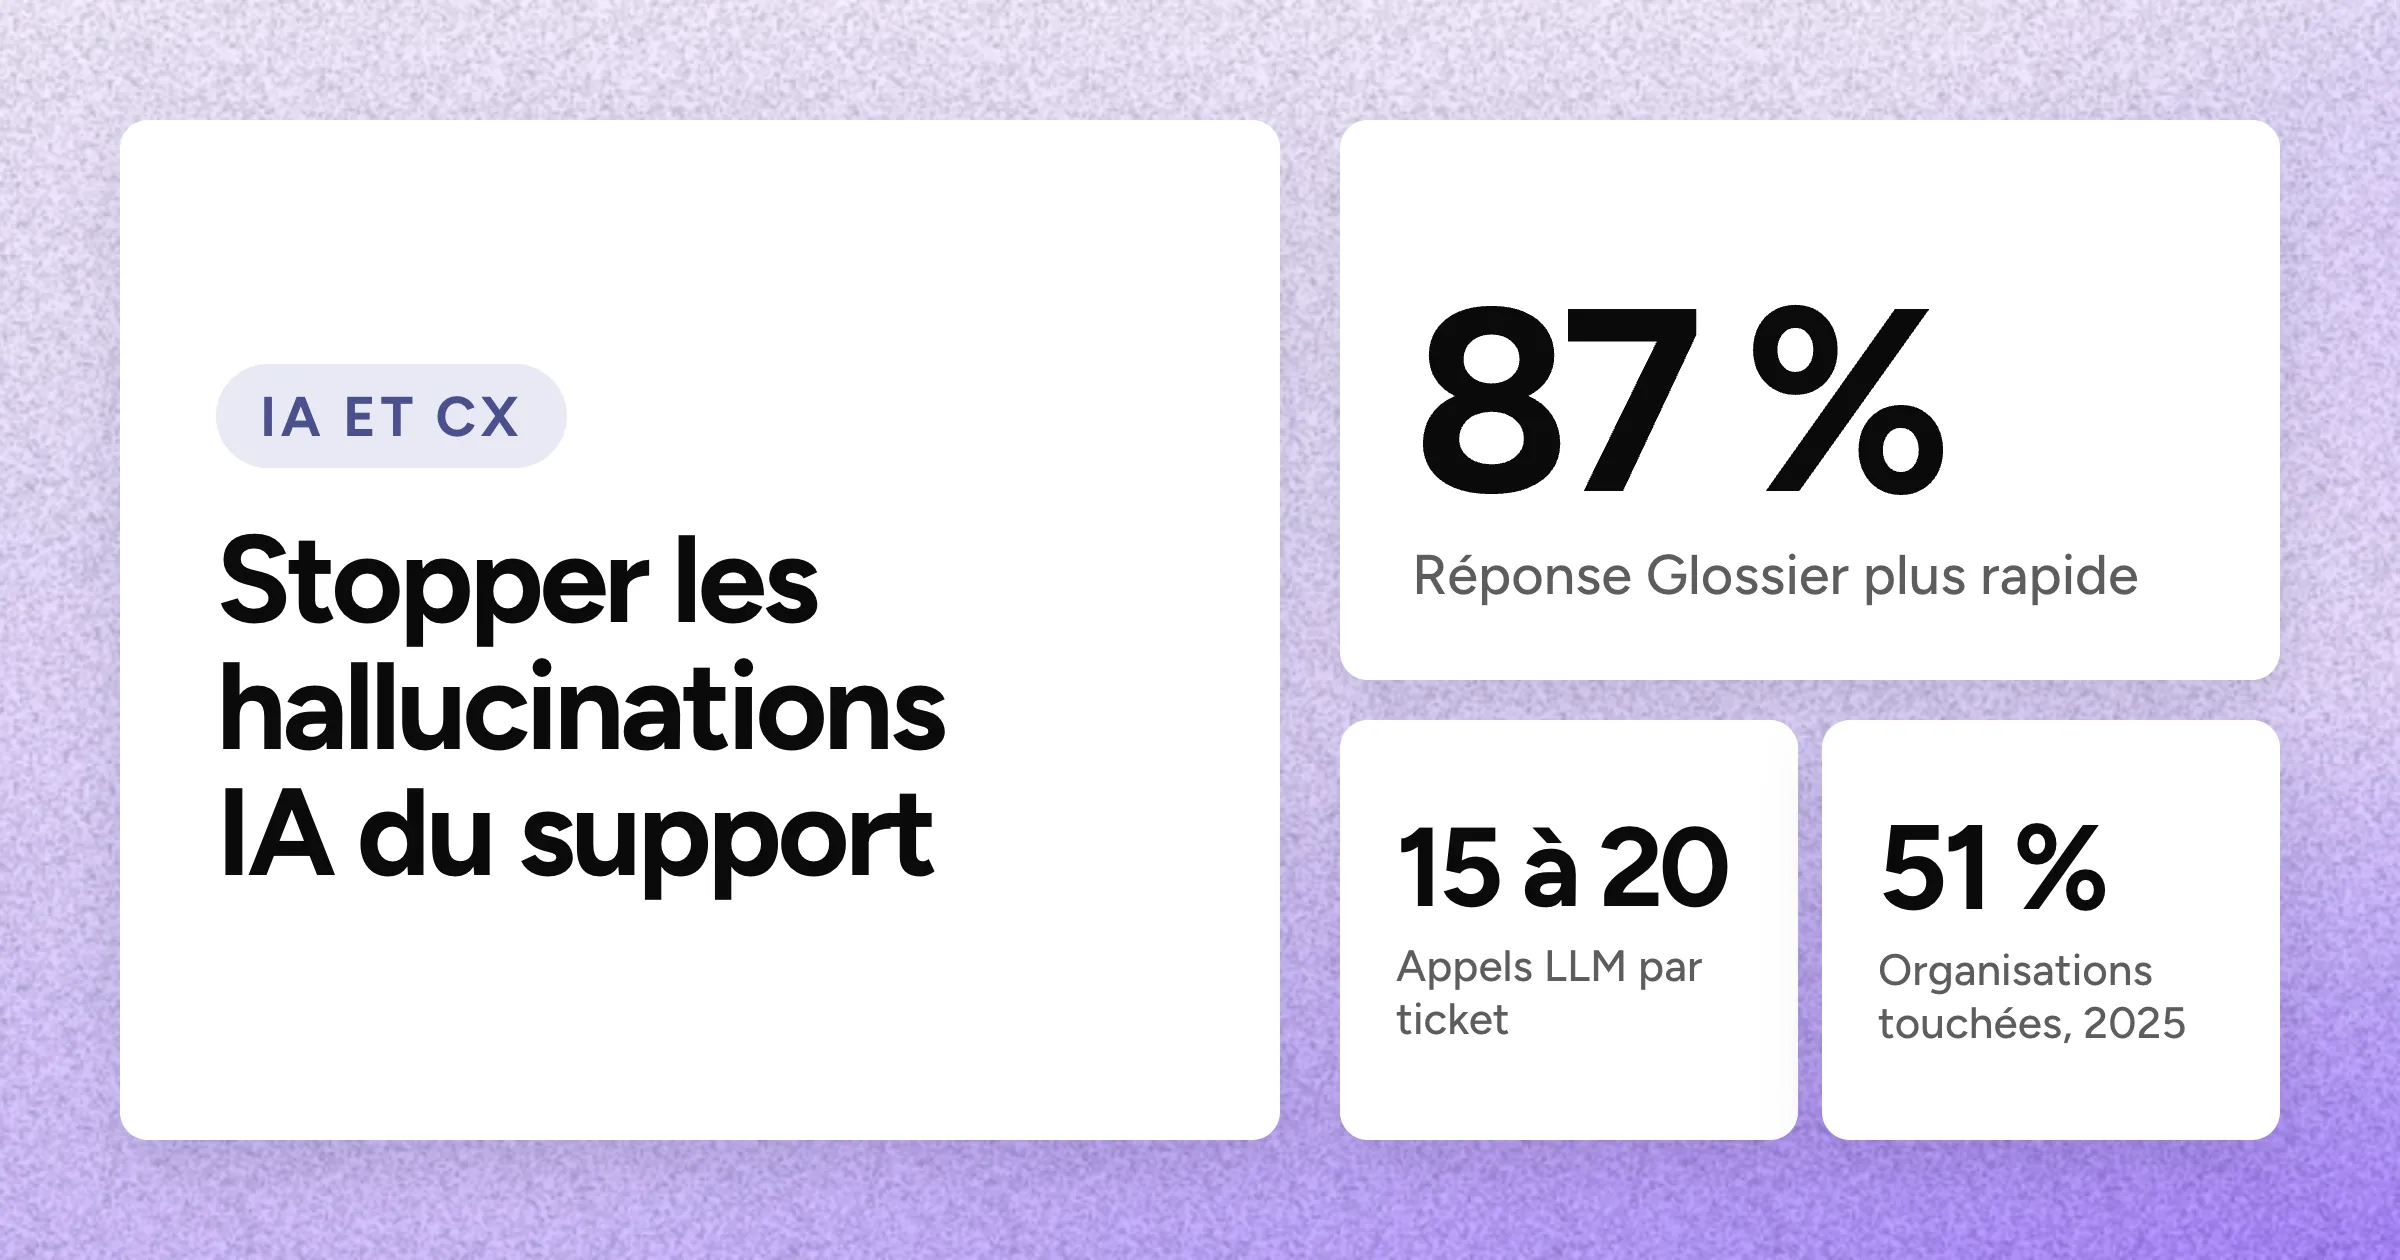
Ce constat se retrouve aussi dans les données. Dans l'enquête mondiale 2024 de McKinsey sur l'IA, l'imprécision était le risque le plus fréquemment signalé avec les déploiements d'IA générative : 44 % des organisations rapportaient au moins une conséquence négative. En 2025, ce chiffre est monté à 51 %. Et côté client, le rapport CX Trends 2026 de Zendesk a révélé que 85 % des responsables service client considèrent qu'un seul problème non résolu suffit à perdre un client.
Quand une IA hallucine dans le service client, le ticket ne reste pas simplement ouvert. C'est la confiance du client qui se ferme.
Pourquoi la plupart des outils de service client automatisé se trompent
La plupart des plateformes IA de service client e-commerce échouent en matière de précision pour des raisons qui dépassent le modèle de langage sous-jacent. Les LLM hallucinent : c'est une caractéristique fondamentale de l'IA à ce jour. C'est pourquoi chaque plateforme IA doit disposer de sa propre architecture de contrôle qualité. C'est l'architecture autour du modèle qui pose problème, et elle a tendance à faillir de trois manières prévisibles.
Instructions vagues
La première est le manque de précision des instructions. De nombreuses plateformes s'appuient sur des prompts formulés de façon imprécise qui demandent à l'IA de « gérer de manière appropriée » ou de « fournir les informations pertinentes ». Ces formulations paraissent raisonnables pour un lecteur humain, mais pour un modèle de langage, c'est une invitation ouverte à improviser. L'expression « tel que » dans une instruction IA est un signal d'alarme : elle indique que l'instruction n'est pas assez précise, et quand les instructions manquent de précision, l'IA comblera probablement le vide avec des informations inventées.
Surcharge d'informations
La deuxième est la surcharge informationnelle. Quand une plateforme donne à l'IA accès à l'intégralité de la base de connaissances pour chaque ticket, les informations non pertinentes entrent en concurrence avec les informations pertinentes pour capter l'attention du modèle. C'est comme confier à un nouvel agent l'ensemble des procédures de l'entreprise dès son premier jour et lui demander de traiter une question sur la livraison. Il serait perdu, et l'IA aussi.
Prompts monolithiques
La troisième est ce qu'une responsable CX a décrit, après un incident d'hallucination dans son entreprise, comme « en gros, un gros prompt ». Beaucoup de plateformes chargent un seul prompt massif contenant toute la logique métier pour tous les scénarios. À mesure que ce prompt grandit, l'IA se perd dans des instructions contradictoires qui se disputent son attention. Une demande de retour ne devrait pas charger simultanément les politiques d'annulation, les seuils de remboursement et les procédures d'expédition. Chacun de ces éléments entre en concurrence pour le focus du modèle et augmente le risque que l'IA puise dans le mauvais référentiel.
Architecture de contrôle qualité
La différence entre une IA qui nuit à votre marque et une qui la protège, ce n'est pas le modèle de langage. C'est ce qui se trouve entre la sortie brute du modèle et la boîte de réception de votre client. Chez Yuma AI, cet espace est occupé par une architecture de contrôle qualité multicouche, conçue autour d'un principe simple : ne jamais laisser l'IA deviner quand elle devrait escalader.
Avec Yuma 2.0, ces couches s'appuient sur le Handbook : un seul ensemble de règles écrit en langage naturel (pages de marque, playbooks et procédures). Chaque playbook a ses propres tests, rejoués en conversations simulées avant toute mise en ligne, et rien ne change tant que vous n'avez pas publié. Quand le Handbook ne couvre pas une demande, Yuma n'improvise pas : il transmet la conversation à une personne et note le manque comme une question ouverte, à laquelle vous ne répondez qu'une fois.
Voici ce que cela donne en pratique.
Architecture de contrôle qualité multicouche
Le contrôle qualité intercepte les erreurs avant que les clients ne les voient
Avant qu'une réponse générée par l'IA n'atteigne un client, elle passe par un portail de contrôle qualité automatisé. Cette vérification évalue si la réponse est pertinente, professionnellement appropriée, contient les informations requises, est alignée avec le ton de marque, et ne contient ni modèles de texte non remplis ni affirmations inventées.
Si la couche de contrôle qualité rejette le brouillon, l'IA réessaye. Si elle échoue à nouveau, le système escalade automatiquement vers un agent humain plutôt que d'envoyer une mauvaise réponse. Comme l'a expliqué un responsable de compte Yuma lors d'un appel d'onboarding client : « Nous avons ce qu'on appelle le contrôle qualité. C'est un peu comme une police, comme des garde-fous, qui va vérifier cette réponse spécifique, ce brouillon spécifique, et va soit mettre un tampon vert, soit un tampon rouge : soit c'est bon, on envoie, soit non. »
Le client ne voit jamais les brouillons recalés.
Plusieurs points de vérification avant les actions irréversibles
Pour les actions à fort enjeu comme les remboursements, les annulations de commande et les modifications d'abonnement, le système impose des points de vérification : des pauses explicites où l'IA doit confirmer qu'elle dispose de toutes les informations nécessaires avant de poursuivre. Avant de traiter un remboursement, par exemple, l'IA doit vérifier le montant, confirmer que la méthode est conforme à la politique en place, et s'assurer que le client a donné son accord. Aucun raccourci, aucune supposition.
Les garde-fous opérationnels limitent les risques
En plus des points de vérification, des garde-fous opérationnels stricts limitent le rayon d'impact de toute erreur individuelle. Montants maximaux de remboursement par commande. Plafonds quotidiens d'annulations. Limites sur les montants des cartes cadeaux et codes promotionnels. Intervalles minimaux entre les cartes cadeaux pour un même client. Ce ne sont pas des consignes souples que l'IA peut contourner : ce sont des limites imposées par le système. Ainsi, même si l'IA commet une erreur, une seule défaillance ne peut pas faire exploser le coût par ticket ni causer des dommages financiers disproportionnés.
Le système « Escalader, ne pas deviner »
La plupart des systèmes IA sont conçus pour tout résoudre. Les plus précis sont conçus pour savoir quand ils ne le peuvent pas. Chaque hallucination est, presque toujours, une IA qui a choisi de deviner plutôt que d'escalader.
La chose la plus sûre qu'une IA puisse faire, c'est admettre qu'elle ne sait pas
L'architecture de Yuma repose sur cette instruction : si vous n'êtes pas sûr à 100 % de la réponse, ne répondez pas au client. Escaladez et demandez à un agent humain de prendre en charge le ticket. C'est un principe de fonctionnement fondamental, intégré dans chaque workflow IA.
L'escalade est définitive par conception
Dès que l'IA escalade un ticket, elle quitte définitivement la conversation. Elle ne se réengage pas, même si de nouveaux messages arrivent. Cela empêche l'IA d'osciller entre traitement automatisé et traitement humain sur un même problème. Le client bénéficie d'un transfert propre, sans aller-retour déroutant entre un bot et une personne.
Déclencheurs d'escalade autonomes
Le système déclenche également des escalades automatiques dans des scénarios d'échec spécifiques, sans attendre la décision de l'IA : échecs répétés du contrôle qualité, boucles d'appels de fonctions dupliqués, outil ou modèle requis introuvable, ou échec de la délégation interne à un autre agent IA. Ces filets de sécurité sont des configurations obligatoires ; ils sont intégrés au système comme des protections fixes qui se déclenchent indépendamment du niveau de confiance de l'IA.
Ancrage dans les connaissances : comment garder l'IA factuelle
Les hallucinations ne proviennent souvent pas du modèle lui-même, mais de la façon dont l'information est organisée et transmise. Des connaissances mal structurées ne font que désorienter l'IA et garantissent des réponses incohérentes.
Séparer « ce qui est vrai » de « ce qu'il faut faire »
L'architecture de connaissances de Yuma impose une séparation nette entre les Faits et les Directives. Les Faits sont des vérités métier discrètes (« Notre fenêtre de retour est de 30 jours »). Les Directives sont des instructions comportementales (« Si un client demande une assistance humaine, escaladez immédiatement »). Quand ces deux éléments sont mélangés dans un même bloc de texte, l'IA peut traiter une instruction de gestion comme un fait, ou un fait comme une instruction. Les séparer élimine toute une catégorie d'erreurs.
La détection automatisée de conflits empêche les réponses contradictoires
Quand de nouvelles connaissances sont ajoutées, le système vérifie automatiquement les contradictions avec les faits existants. Si deux entrées se contredisent (« retours gratuits sous 30 jours » versus « fenêtre de retour de 14 jours »), le système signale le conflit. Un système de priorités (les faits créés manuellement pèsent plus que ceux extraits automatiquement) garantit des réponses cohérentes. Sans cette détection, l'IA retient la première information qu'elle rencontre et donne des réponses aléatoires à la même question d'un ticket à l'autre.
Les données dynamiques ne sont jamais stockées comme connaissances statiques
L'architecture de Yuma interdit explicitement de stocker les prix, les niveaux de stock, les statuts de commande ou toute donnée fréquemment mise à jour dans le Handbook. Ces informations doivent être récupérées en temps réel via les intégrations pendant le traitement du ticket. Stocker « L'article X coûte 50 € » comme fait dans la base signifie que l'IA citera toujours 50 € après un changement de prix. L'obligation de données en temps réel élimine toute cette catégorie d'hallucinations liées aux informations périmées.
Le suivi d'utilisation des connaissances révèle les angles morts
Le système suit quelles entrées du Handbook l'IA utilise réellement dans ses réponses. Les entrées jamais consultées sont remontées pour examen (elles sont peut-être mal rédigées ou hors sujet). Les entrées fréquemment consultées mais qui mènent à des escalades sont signalées comme potentiellement confuses. Cette boucle de rétroaction fait que le Handbook s'améliore en continu, au lieu de se dégrader silencieusement au fil du temps.
Workflows déterministes quand la précision n'est pas négociable
Tout ne doit pas être laissé au jugement de l'IA
Certains processus sont trop critiques ou trop encadrés par des règles pour être confiés au raisonnement probabiliste de l'IA. Les entreprises doivent identifier leurs propres cas limites et éventuellement les exclure de l'automatisation IA du service client, en particulier ceux qui sont très sensibles et nécessitent des informations contextuelles pour être traités correctement.
Architecture hybride : flexibilité de l'IA + contrôle déterministe
Yuma utilise une approche hybride qui associe le raisonnement IA (pour comprendre l'intention, le sentiment et le contexte) à une logique déterministe (pour exécuter les actions qui exigent de la précision). L'IA e-commerce gère la conversation. Des règles codées en dur gèrent les calculs et l'application des politiques. Cette combinaison permet à l'IA d'être conversationnelle et adaptative tandis que la logique métier critique reste exacte et auditable.
Déploiement sécurisé : tester la précision en production
Déploiement progressif avec un comportement cohérent
L'architecture peut encore être insuffisante si une marque doit passer de zéro à une automatisation complète du jour au lendemain. Il est fortement recommandé de déployer l'IA de façon progressive. Cela ne doit pas nécessairement prendre des jours : il suffit de procéder par petits incréments avant que l'IA ne soit pleinement entraînée et synchronisée avec les opérations de service client de la marque. Yuma déploie chaque nouveau playbook sur un faible pourcentage, en commençant à 5 % du volume de tickets correspondants, avec un système de hachage par ticket qui garantit que le même ticket reçoit toujours la même décision de déploiement. Cela permet de tester en conditions réelles avec de vraies conversations clients.
Comme l'a décrit un membre de l'équipe Yuma lors d'un appel commercial : « On ne se contente pas de tout mettre en production pour voir ce qui se passe. On commence à 20 % de tous les tickets correspondant à ce cas d'usage précis, on observe, on voit si ça nous convient. En général, ce qui se passe, c'est qu'on réalise ensemble avec vous, oups, on a oublié ce cas de figure. OK, faisons en sorte que ce cas soit toujours escaladé. »
Les actions destructives sont toujours simulées pendant les tests
Pendant la phase de déploiement, le système exécute les actions destructives (remboursements, annulations, modifications d'abonnement) en mode simulation. L'IA exécute sa logique complète sans déclencher réellement l'action, ce qui permet aux équipes de vérifier la précision avant que quoi que ce soit de réel ne se produise. Les marques examinent chaque réponse, identifient les cas limites, et n'augmentent le volume que lorsque la fiabilité est démontrée par des données réelles.
La cohérence de marque comme dimension de la précision
Une réponse hors ton est une forme d'inexactitude
Une IA qui fournit des informations factuellement correctes dans le mauvais ton nuit tout de même à la relation client. Si l'IA d'une marque de luxe répond avec un ton familier, ou si l'IA d'une marque DTC au ton décalé sonne comme un document juridique, l'expérience client en pâtit même quand l'information est techniquement juste. Le portail de contrôle qualité de Yuma évalue l'alignement avec le ton de marque dans le cadre de sa validation, traitant les écarts de tonalité comme des échecs nécessitant un nouvel essai.
La hiérarchie par priorités empêche les instructions contradictoires
Quand plusieurs instructions peuvent s'appliquer à un même ticket, une hiérarchie par priorités détermine laquelle prévaut. Les instructions créées manuellement, à haute priorité, l'emportent sur celles générées automatiquement. Cela empêche l'IA de choisir aléatoirement entre des consignes contradictoires, l'une des formes d'incohérence les plus subtiles et les plus difficiles à détecter dans le service client IA.
Protection circulaire et prévention des boucles infinies
Plusieurs couches de protection contre les boucles
Quand un agent IA se bloque (en répétant le même appel de fonction, en réentrant dans la même branche de workflow, ou en alternant entre deux réponses), le système détecte la boucle et force une escalade. Cette protection opère à plusieurs niveaux : détection d'appels de fonctions dupliqués, limites de réentrée dans les workflows, et surveillance des répétitions au niveau de la conversation. Sans cela, une IA bloquée peut envoyer trois ou quatre fois la même réponse à un client avant que quiconque ne s'en aperçoive.
Mots-clés interdits : le frein d'urgence
Dernier rempart : le filtrage du contenu
Même quand toutes les couches précédentes sont en place, Yuma inclut un filtre de sortie final : une liste de mots-clés interdits qui empêche certains mots ou expressions d'apparaître dans les messages envoyés aux clients. Si l'IA génère une réponse contenant un terme interdit (nom d'un concurrent, code interne, mot inapproprié), la réponse est bloquée avant envoi. C'est un outil volontairement radical : le dernier rempart quand toutes les autres couches ont déjà fait leur travail.
L'expérience de Glossier valide cette approche architecturale. Comme l'a formulé Amy Kemp, Directrice de l'Expérience Client Omnicanale chez Glossier :
Confier toute notre base de connaissances à un grand modèle IA, ce n'était pas la bonne approche pour nous. L'approche de Yuma, créer des automatisations IA dédiées par motif de contact, nous permettait de contrôler précisément ce qui était partagé, et de réduire le risque d'hallucinations IA. Avec Yuma, Glossier a réduit son temps de réponse de 87 %.